61年间三起三落,为何人工智能在今年得到爆发?
人工智能(AI)自1956年达特茅斯会议诞生以来,已经走过了61年的曲折历程。期间,AI经历了三次大的兴起与衰落,被称为“三起三落”。在2017年前后,AI突然迎来了前所未有的爆发式增长,吸引了全球范围内的资本、人才和产业关注。这背后的驱动力究竟是什么?本文将回顾AI的三起三落,并重点分析其爆发的基础资源与技术因素。
一、AI的三起三落
第一次兴起(1956-1974):达特茅斯会议上,麦卡锡、明斯基等学者首次提出“人工智能”概念,乐观情绪高涨。早期程序如逻辑理论家、通用问题求解器展示了符号推理的能力。但由于计算能力有限、组合爆炸等问题,AI很快陷入低谷。
第二次兴起(1980-1987):专家系统在商业领域取得成功,如DEC的XCON系统。日本更是提出“第五代计算机”计划。但专家系统知识获取困难、维护成本高,加之硬件性能不足,再次遇冷。
第三次兴起(1993-2006):基于统计的方法兴起,如隐马尔可夫模型、支持向量机等。1997年深蓝战胜卡斯帕罗夫,但整体进展缓慢,AI进入平稳发展期。
第四次爆发(2010年代至今):2012年AlexNet在ImageNet竞赛中夺冠,深度学习引爆新一轮热潮。2016年AlphaGo击败李世石,2017年Transformer架构提出,AI进入大规模应用阶段。
二、为何AI在今年得到爆发?
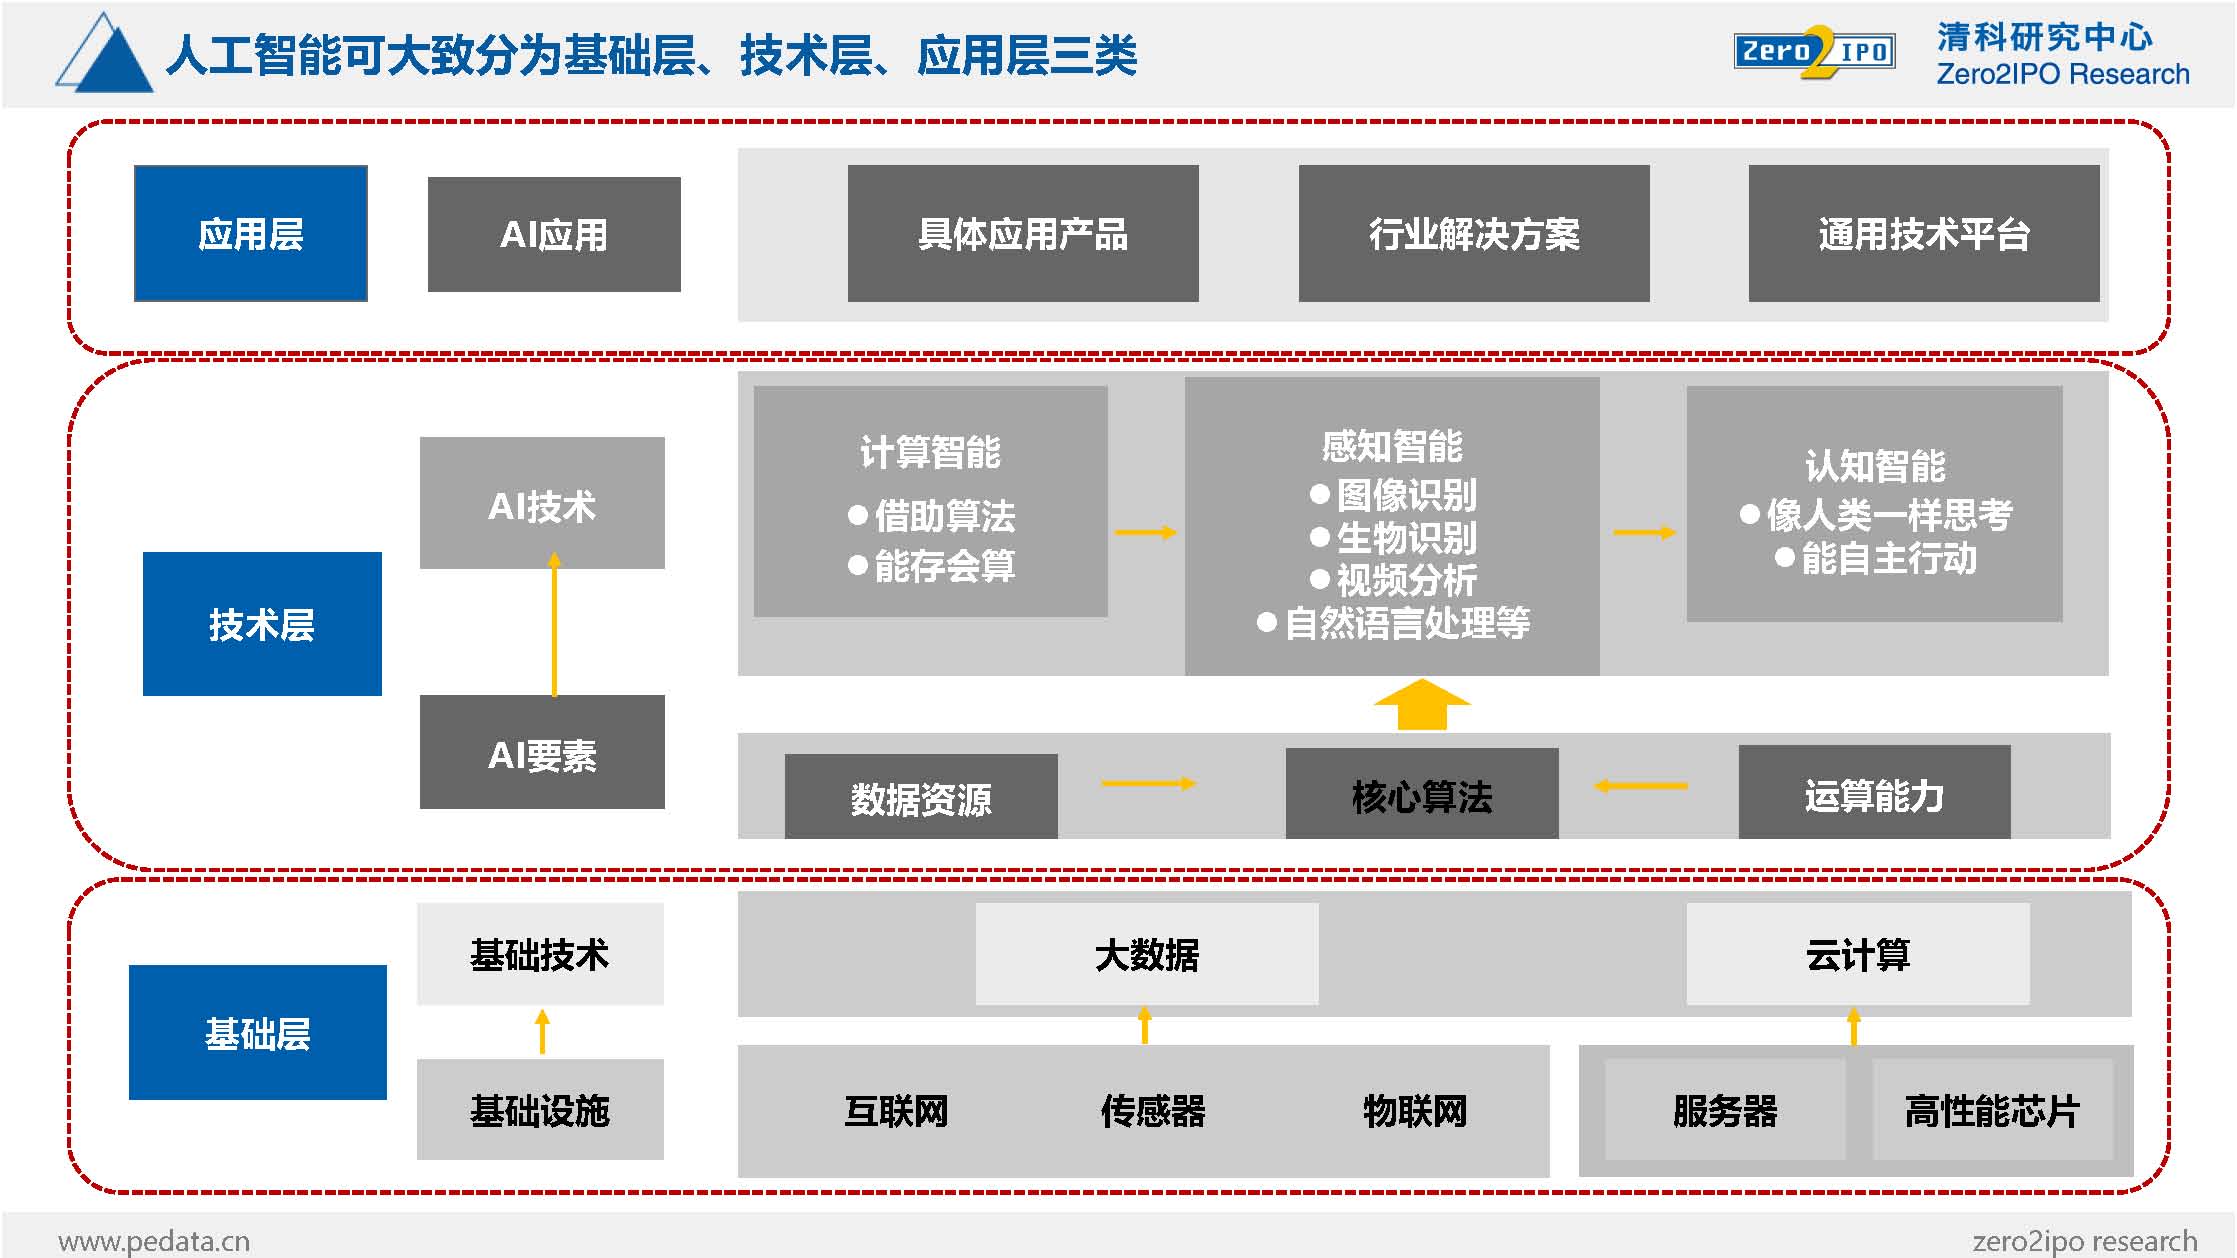
所谓的“今年”并非特指某一天,而是以2017年为标志性节点,AI迎来了从技术到产业的全面爆发。究其原因,主要有以下基础资源与技术方面的突破:
1. 数据资源的大爆发
互联网、移动互联网、物联网的普及,产生了海量的文本、图像、语音、视频等数据。根据IDC报告,全球数据总量从2005年的0.1ZB增长到2017年的21ZB。这些数据为训练复杂的AI模型提供了充足的“燃料”。深度学习尤其依赖大规模标注数据,ImageNet数据集包含1400万张标注图像,成为AI爆发的关键资源之一。
2. 计算能力的飞跃
GPU的广泛应用为AI训练提供了强大算力。相比CPU,GPU拥有数千个核心,适合并行计算。NVIDIA推出的CUDA编程框架,使研究人员能轻松利用GPU加速神经网络训练。2012年AlexNet使用两块GTX 580 GPU训练,将图像识别错误率大幅降低。谷歌TPU等专用芯片进一步提升了AI计算效率。云计算平台(如AWS、Azure、阿里云)则降低了算力获取门槛。
3. 算法与模型的突破
- 深度学习:2006年Hinton等人提出深度信念网络,开启深度学习复兴。2012年AlexNet采用卷积神经网络(CNN),在ImageNet上取得突破。
- 循环神经网络(RNN)与长短期记忆(LSTM):在序列数据处理(如语音识别、机器翻译)中表现优异。
- 生成对抗网络(GAN):2014年由Goodfellow提出,推动图像生成等领域发展。
- 注意力机制与Transformer:2017年谷歌发表《Attention is All You Need》,提出Transformer架构,成为后续BERT、GPT等模型的基础。
- 强化学习:AlphaGo结合深度神经网络与蒙特卡洛树搜索,展示了AI在复杂博弈中的能力。
这些算法创新大幅提升了AI在感知、理解、生成等方面的性能。
4. 开源生态与工具链成熟
TensorFlow(2015)、PyTorch(2016)等深度学习框架的开源,降低了AI开发门槛。Caffe、Keras、MXNet等工具也促进了技术传播。预训练模型(如Word2Vec、GloVe)和迁移学习使小团队也能快速构建应用。
5. 产业需求与资本推动
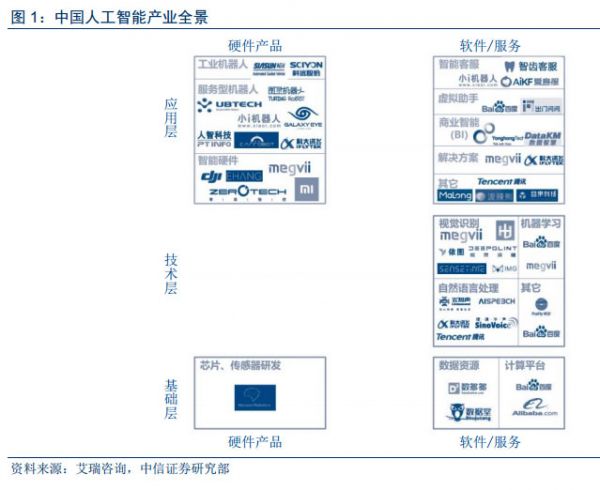
互联网巨头(谷歌、Facebook、百度、腾讯等)积极布局AI,投入巨资研发。传统行业如金融、医疗、安防、自动驾驶等对AI需求旺盛。风险投资大量涌入,2017年全球AI融资额超过100亿美元。政策层面,中国发布《新一代人工智能发展规划》,美国、欧盟也推出相关战略。
三、
AI的三起三落反映了技术发展的波浪式前进。2017年的爆发并非偶然,而是数据资源、计算能力、算法模型、开源生态和产业资本共同作用的结果。尤其值得注意的是,基础资源的成熟(大数据+GPU+云计算)与技术突破(深度学习+Transformer)形成了正向循环,使AI从实验室走向大规模商业化。随着量子计算、神经形态芯片等新技术的出现,AI有望迎来新的飞跃,但也需警惕伦理、安全等挑战。
如若转载,请注明出处:http://www.taokebarr.com/product/42.html
更新时间:2026-10-11 13:04:52