人工智能基础资源与技术 构建智能时代的基石
引言
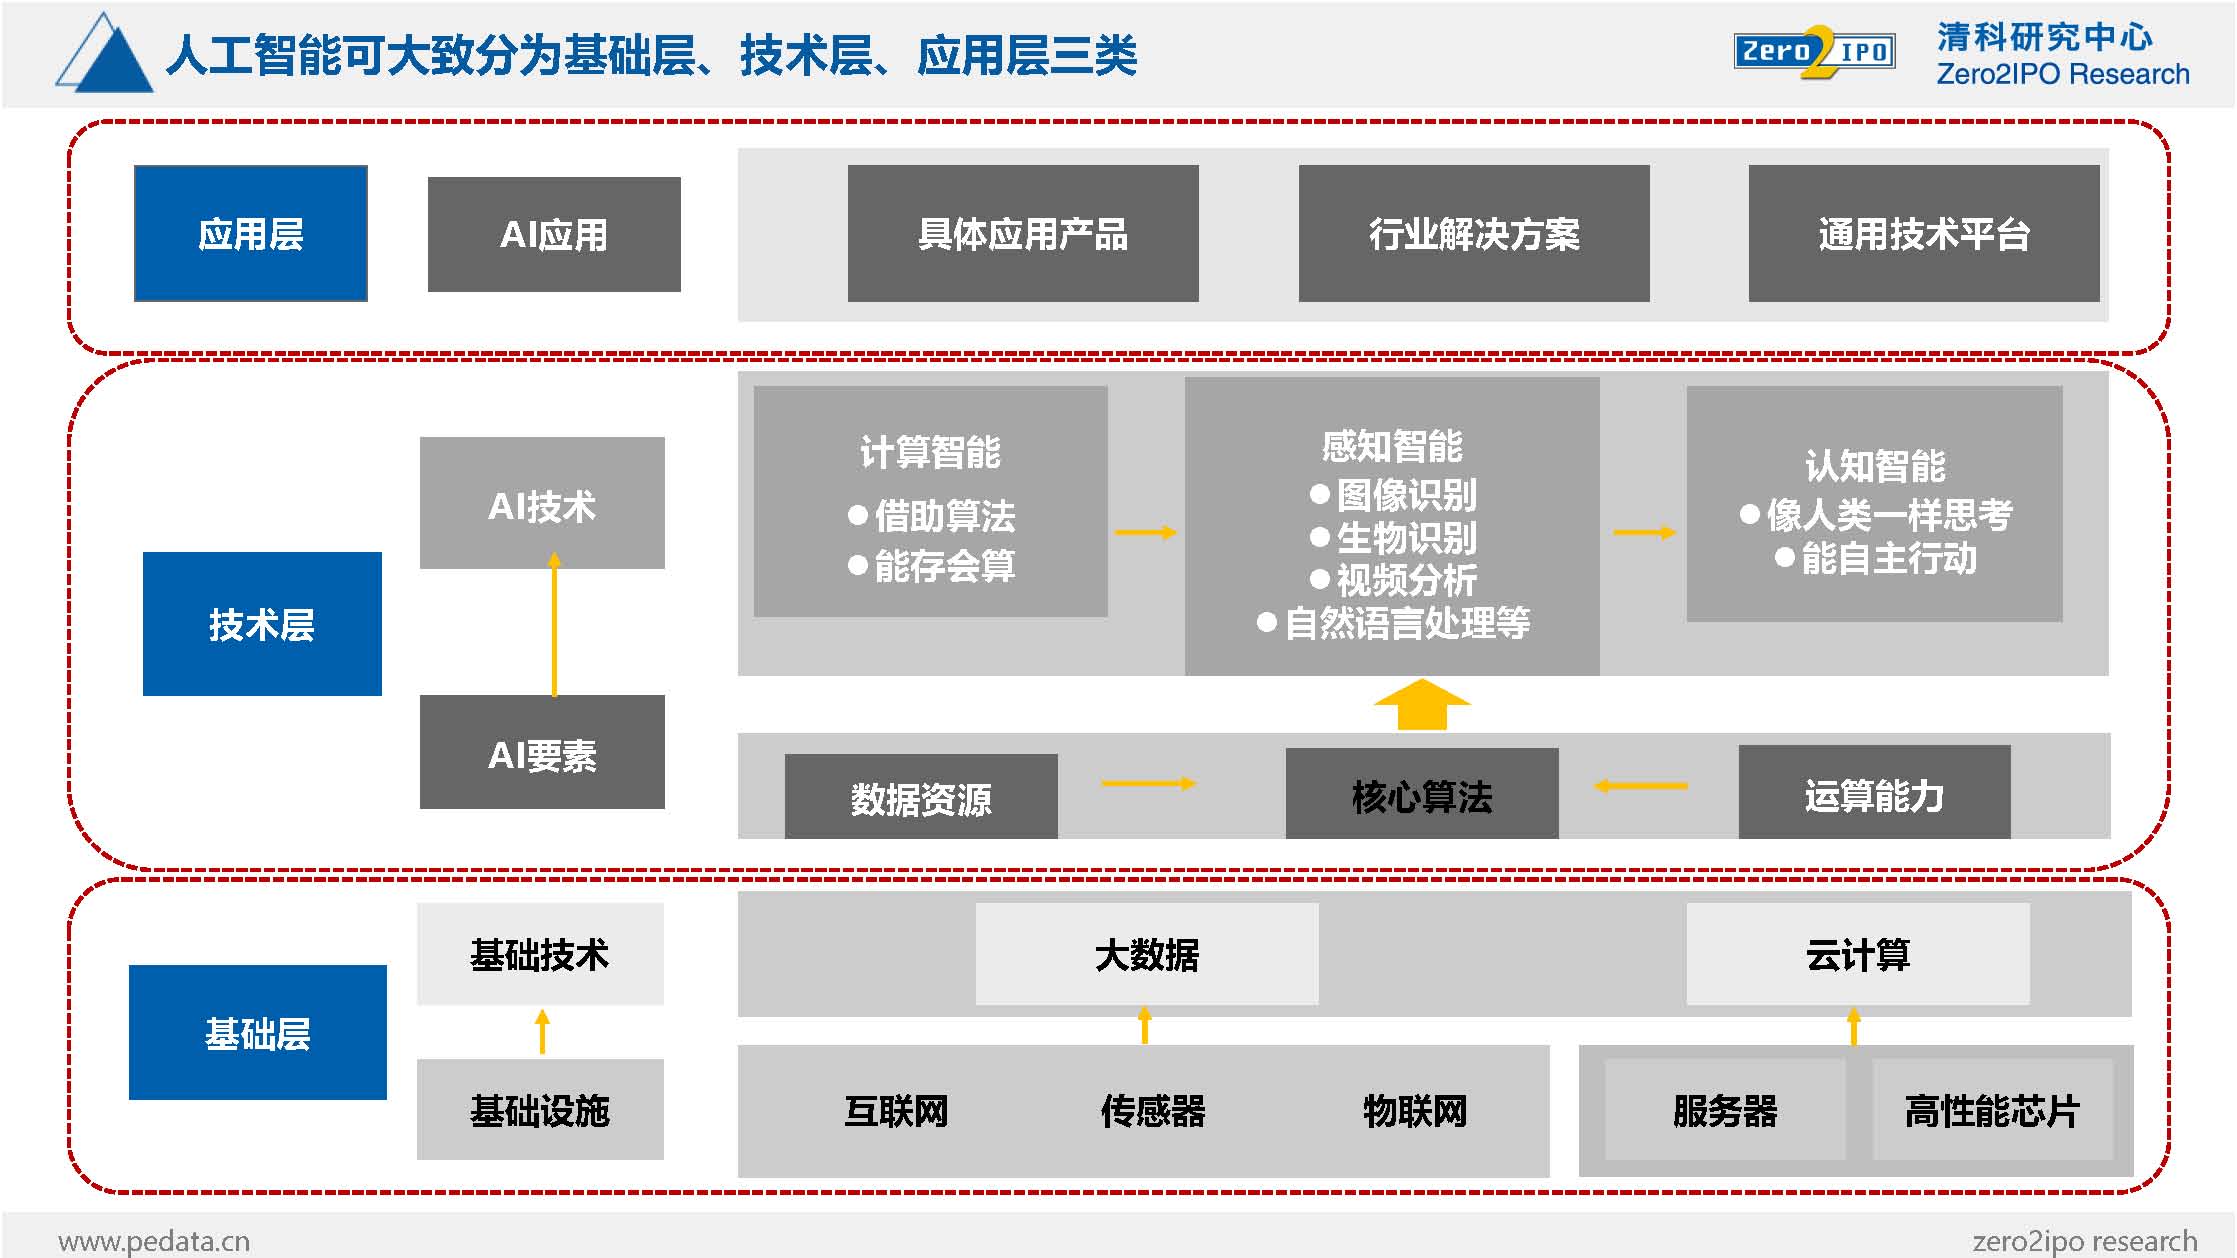
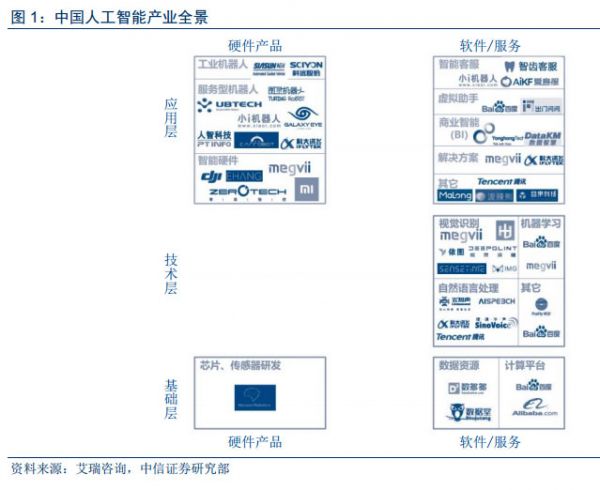
人工智能(AI)的飞速发展正深刻改变着社会生产与生活方式,而其背后离不开两大核心支撑:基础资源与技术体系。基础资源为AI提供了数据、算力和算法生长的土壤,技术则是将这些资源转化为智能应用的手段。理解人工智能的基础资源与技术,是把握AI发展脉络、推动创新应用的关键。
一、人工智能的基础资源
1. 数据资源
数据是人工智能的“燃料”。无论是监督学习、无监督学习还是强化学习,都需要大量高质量的数据进行训练和验证。数据资源包括:
- 结构化数据:如数据库中的表格数据,常用于传统机器学习任务。
- 非结构化数据:如文本、图像、音频、视频,是深度学习模型的主要输入。
- 标注数据:经过人工标记的数据集,对监督学习至关重要,但获取成本高昂。
数据资源的规模、多样性和质量直接影响AI模型的性能。当前,数据隐私、数据孤岛和数据偏见等问题也成为制约AI发展的重要挑战。
2. 计算资源
计算能力是AI模型训练与推理的引擎。随着深度学习模型参数量的爆炸式增长(如GPT系列、BERT等),对算力的需求呈指数级上升。
- 硬件 accelerators:GPU(图形处理单元)、TPU(张量处理单元)、FPGA等专用芯片大幅提升了并行计算效率。
- 云计算平台:AWS、Azure、阿里云等提供弹性可扩展的算力服务,降低了AI研发门槛。
- 边缘计算:将计算能力下沉到终端设备,满足低延迟、隐私保护等场景需求。
3. 算法资源
算法是AI的灵魂。经典的机器学习算法(如决策树、支持向量机)与深度学习算法(如卷积神经网络、循环神经网络、Transformer)构成了丰富的算法库。开源框架如TensorFlow、PyTorch、PaddlePaddle等,极大推动了算法的共享与迭代。
4. 人才与知识资源
AI人才是重要的智力资源,包括数据科学家、算法工程师、领域专家等。学术论文、开源社区、竞赛平台(如Kaggle)等知识资源促进了技术的传播与创新。
二、人工智能的核心技术
1. 机器学习
机器学习是AI的核心技术,研究计算机如何从数据中自动学习规律并改进。主要范式包括:
- 监督学习:从标注数据中学习映射关系,应用于分类、回归。
- 无监督学习:发现数据内在结构,如聚类、降维。
- 半监督学习:结合少量标注与大量未标注数据。
- 强化学习:通过与环境交互、试错学习最优策略。
2. 深度学习
深度学习基于多层神经网络,自动提取特征。典型模型有:
- CNN:擅长图像处理,应用于计算机视觉。
- RNN/LSTM:处理序列数据,用于自然语言处理、语音识别。
- Transformer:基于自注意力机制,成为大语言模型的基础架构。
- 生成模型:如GAN、VAE、扩散模型,用于图像生成、数据增强。
3. 自然语言处理(NLP)
NLP让机器理解、生成人类语言。关键技术包括词嵌入、句法分析、机器翻译、情感分析、问答系统等。预训练语言模型(如BERT、GPT)显著提升了NLP任务的表现。
4. 计算机视觉(CV)
CV使机器“看懂”世界,包括图像分类、目标检测、语义分割、人脸识别、三维重建等。深度学习尤其是CNN的引入,使CV在准确率上超越了人类水平。
5. 语音技术
语音识别(ASR)将语音转为文本,语音合成(TTS)将文本转为语音。端到端模型和注意力机制的应用,大幅提升了识别与合成的自然度。
6. 知识图谱与推理
知识图谱以图结构表示实体与关系,支持智能搜索、推荐和决策。结合逻辑推理与表示学习,可实现可解释的AI。
7. 机器人学与自动驾驶
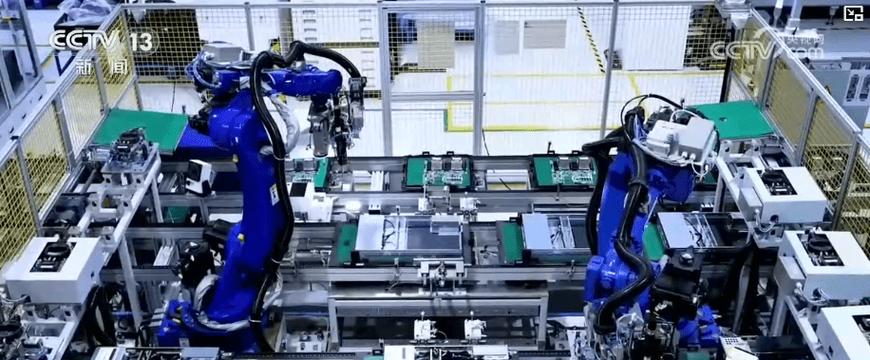
结合感知、规划与控制技术,机器人学和自动驾驶是AI在物理世界的重要应用。SLAM、路径规划、多传感器融合等技术不断成熟。
三、基础资源与技术的协同演进
基础资源与技术相辅相成。数据规模的扩大催生了深度学习算法;算力的提升使得大模型训练成为可能;算法创新又反过来推动了对新型计算架构的需求。AI发展将呈现以下趋势:
- 资源高效化:小样本学习、自监督学习降低对标注数据的依赖;模型压缩、边缘计算降低算力需求。
- 技术融合化:多模态学习融合文本、图像、语音,实现更全面的智能。
- 平台化与自动化:AutoML、MLOps等工具降低AI开发门槛,加速落地。
- 可信AI:关注公平性、可解释性、隐私保护与安全性。
##
人工智能的基础资源(数据、算力、算法、人才)与技术(机器学习、深度学习、NLP、CV等)共同构成了智能时代的基石。理解它们的相互作用,有助于我们更好地把握AI的发展方向,推动技术创新与产业应用。面对我们需持续投入基础资源建设,突破核心技术瓶颈,让人工智能更好地服务于人类社会。
如若转载,请注明出处:http://www.taokebarr.com/product/48.html
更新时间:2026-10-11 22:58:20