数据服务 人工智能基础资源与技术研发的基石
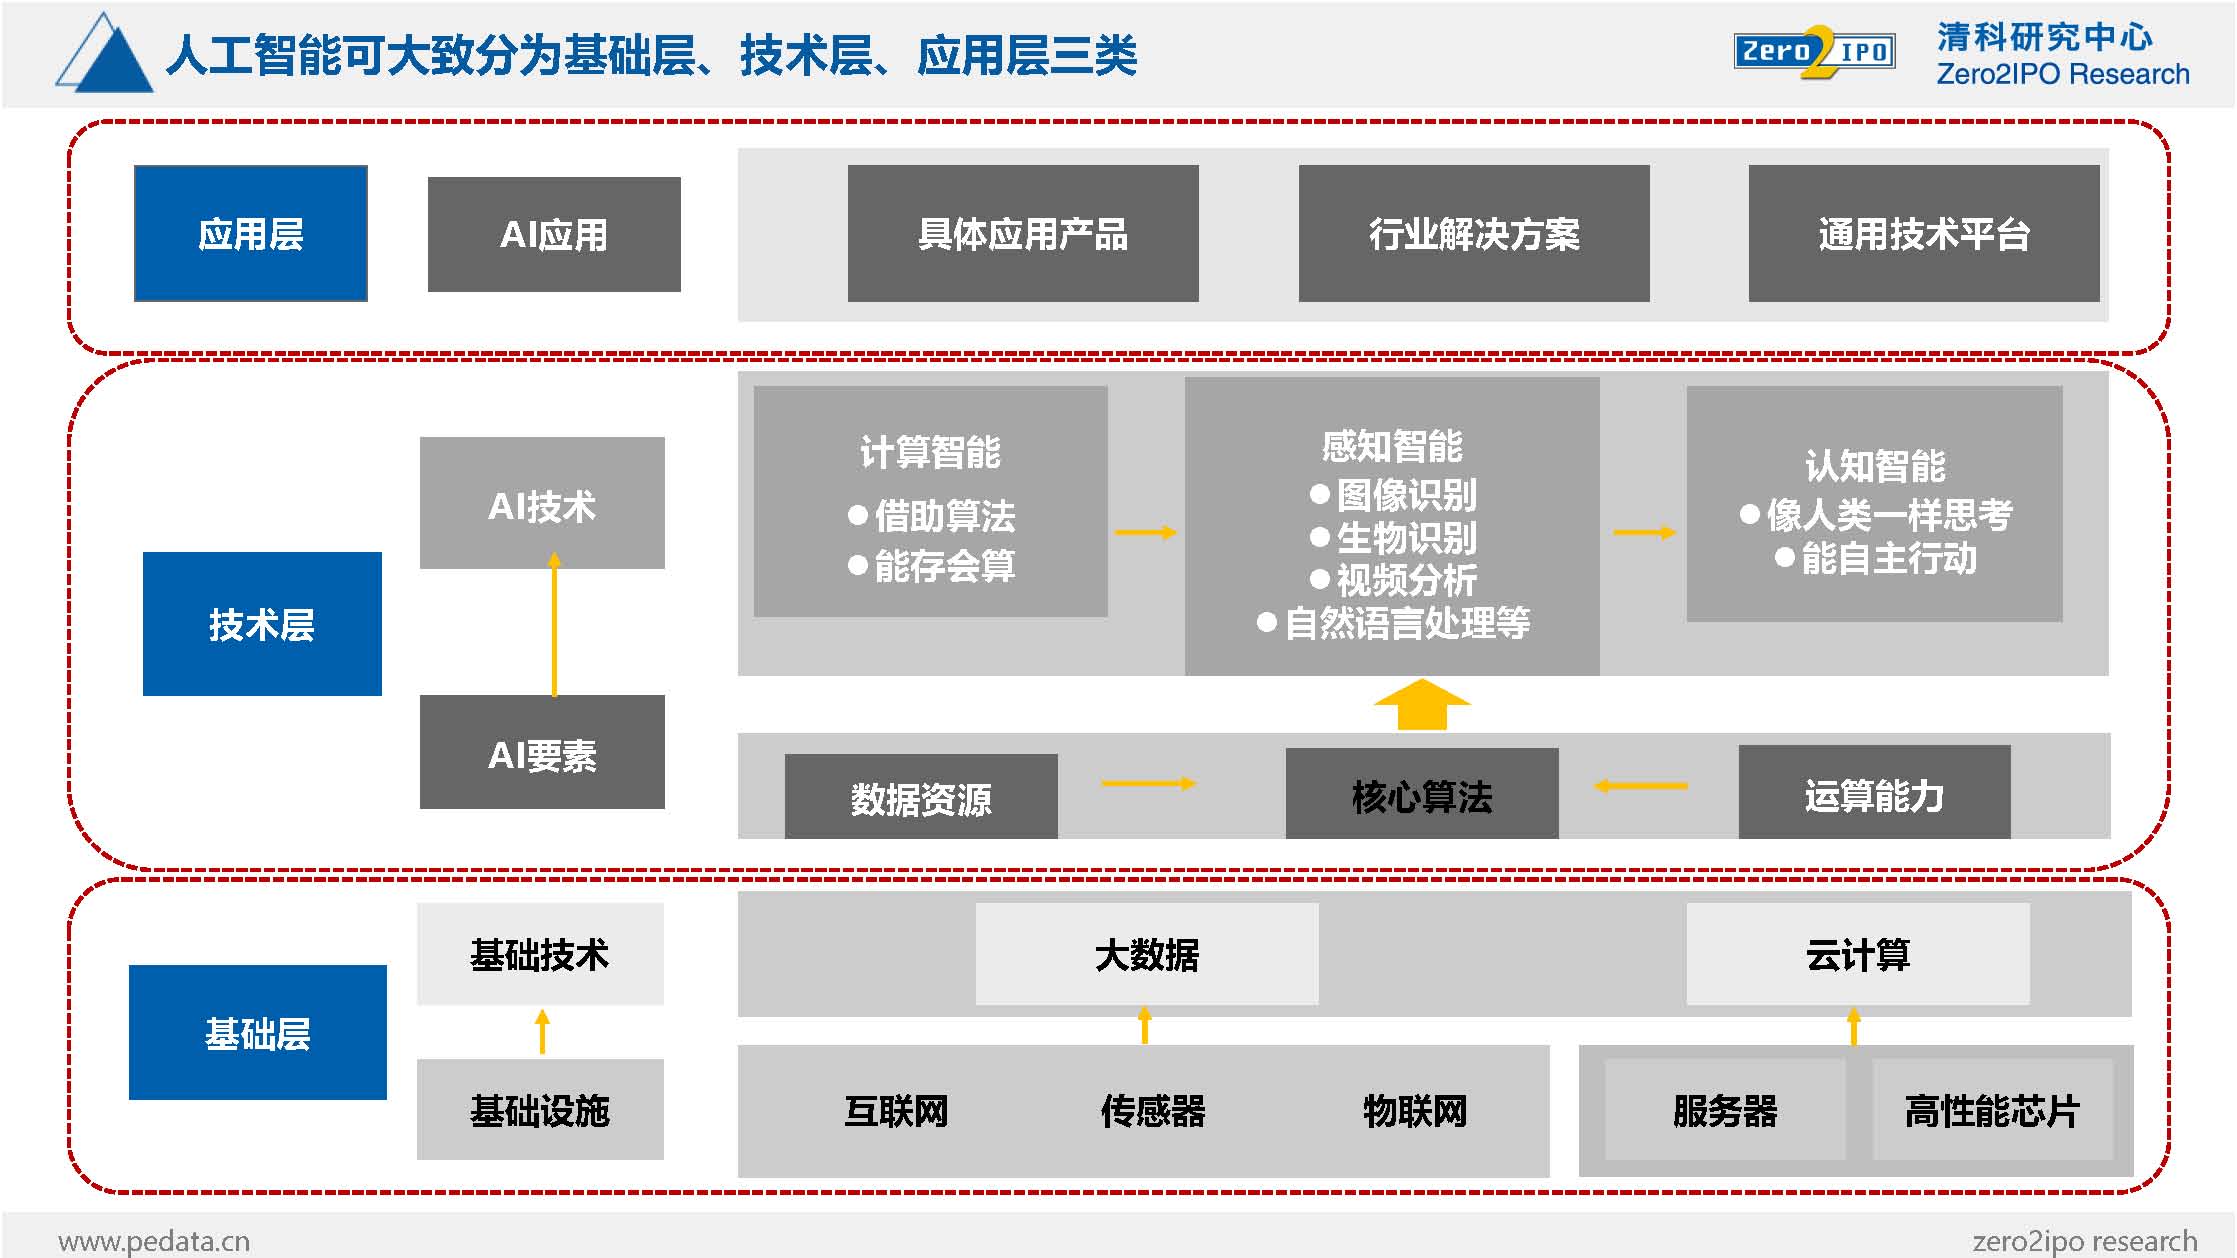
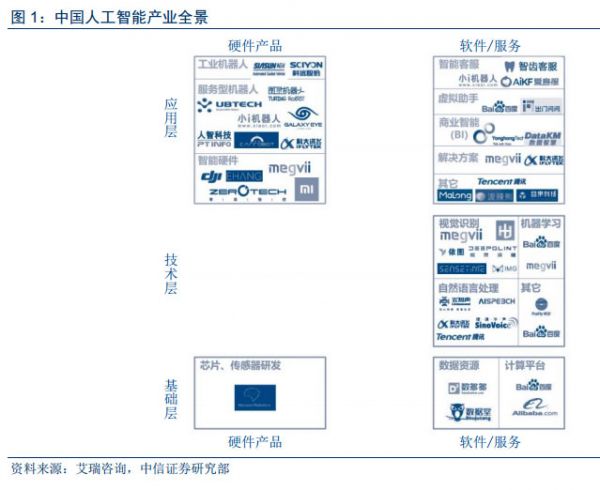
人工智能(AI)技术的蓬勃发展,离不开高质量数据的强力支撑。数据服务作为连接原始数据与AI模型的关键桥梁,涵盖了从数据收集、清洗、标注到存储、管理、分发等全生命周期环节,为AI技术的研发与应用提供了不可或缺的基础资源。
一、数据收集:AI的“原材料”获取
数据收集是数据服务的起点,也是AI基础资源的源头活水。无论是监督学习所需的标注数据集,还是无监督学习依赖的海量原始数据,都需要通过系统化的收集策略获取。常见的数据收集渠道包括:公开数据集(如ImageNet、COCO)、网络爬虫、传感器采集(物联网设备、摄像头)、用户生成内容(社交媒体、日志)以及专业数据采购。收集过程中需兼顾数据的多样性、代表性和合规性,以确保AI模型能够泛化到真实场景,同时规避隐私与法律风险。
二、数据标注:赋予数据“智能”的必要加工
原始数据通常是非结构化的,直接用于训练效果有限。数据标注通过人工或半自动方式为目标变量打上标签,例如图像分类中的类别标注、目标检测中的边界框、语音转写中的文本对齐等。高质量的标注是监督学习成功的先决条件。常见的数据标注服务形式包括外包众包、专家标注以及基于预训练模型的自动标注,后者可显著降低成本和周期。标注质量评估与一致性检验(如Kappa系数)也是数据服务的重要环节。
三、数据清洗与预处理:提升数据可用性
真实世界的数据往往包含噪声、缺失值、异常值或重复记录。数据服务提供清洗与预处理流程,包括去重、纠错、填补缺失、归一化、格式转换等操作。数据增强技术(如图像旋转、剪裁、文本同义替换)能够在有限数据基础上扩充训练集,提升AI模型的鲁棒性和泛化能力。数据预处理的质量直接关系到模型训练的收敛速度和最终精度。
四、数据存储与管理:支撑大规模AI训练
大规模AI模型(如深度学习网络)对数据存储与管理提出极高要求。数据服务需要提供可扩展的存储方案(分布式文件系统、对象存储、数据库),以及高效的数据检索与版本管理能力。数据集版本化、数据血缘追踪、跨团队共享与权限控制,都是现代AI基础设施中的关键数据管理技术。例如,特征存储(Feature Store)的兴起使得训练与推理阶段的数据特征保持一致,降低了重复开发成本。
五、数据安全与隐私:AI合规发展的保障
随着法规(如GDPR、个人信息保护法)的完善,数据服务必须融入隐私保护技术,如差分隐私、联邦学习、同态加密、可信执行环境等。这些技术使AI模型能够在不出域、不泄露原始数据的前提下进行联合训练,平衡数据利用与隐私安全。数据脱敏、去标识化、访问审计等机制也是数据服务提供商的标配能力。
六、数据服务生态的演进趋势
当前,数据服务正从粗放的采集供应向智能化、平台化方向发展。自动化标注、主动学习(让模型选择最有价值的数据进行标注)、合成数据生成、数据市场与交易平台等新兴模式不断涌现。基础资源与技术也呈现融合态势:数据服务与算力服务(GPU集群)、算法服务(模型库、自动机器学习)结合,形成端到端的AI开发平台(如MLOps)。这种集成化数据服务降低了AI应用门槛,加速了技术从实验室走向产业落地。
数据服务作为人工智能的基础资源性与技术使能环节,其质量与能力直接决定了AI系统的表现上限。随着多模态大模型与通用人工智能的探索,数据服务将在自监督学习、跨域数据融合、动态持续学习等方面发挥更关键的作用。重视并投资高效、合规、智能的数据服务基础设施,是推动AI技术可持续发展的必由之路。
如若转载,请注明出处:http://www.taokebarr.com/product/45.html
更新时间:2026-10-11 22:01:43