人工智能基础资源与技术 从计算基石到智能引擎
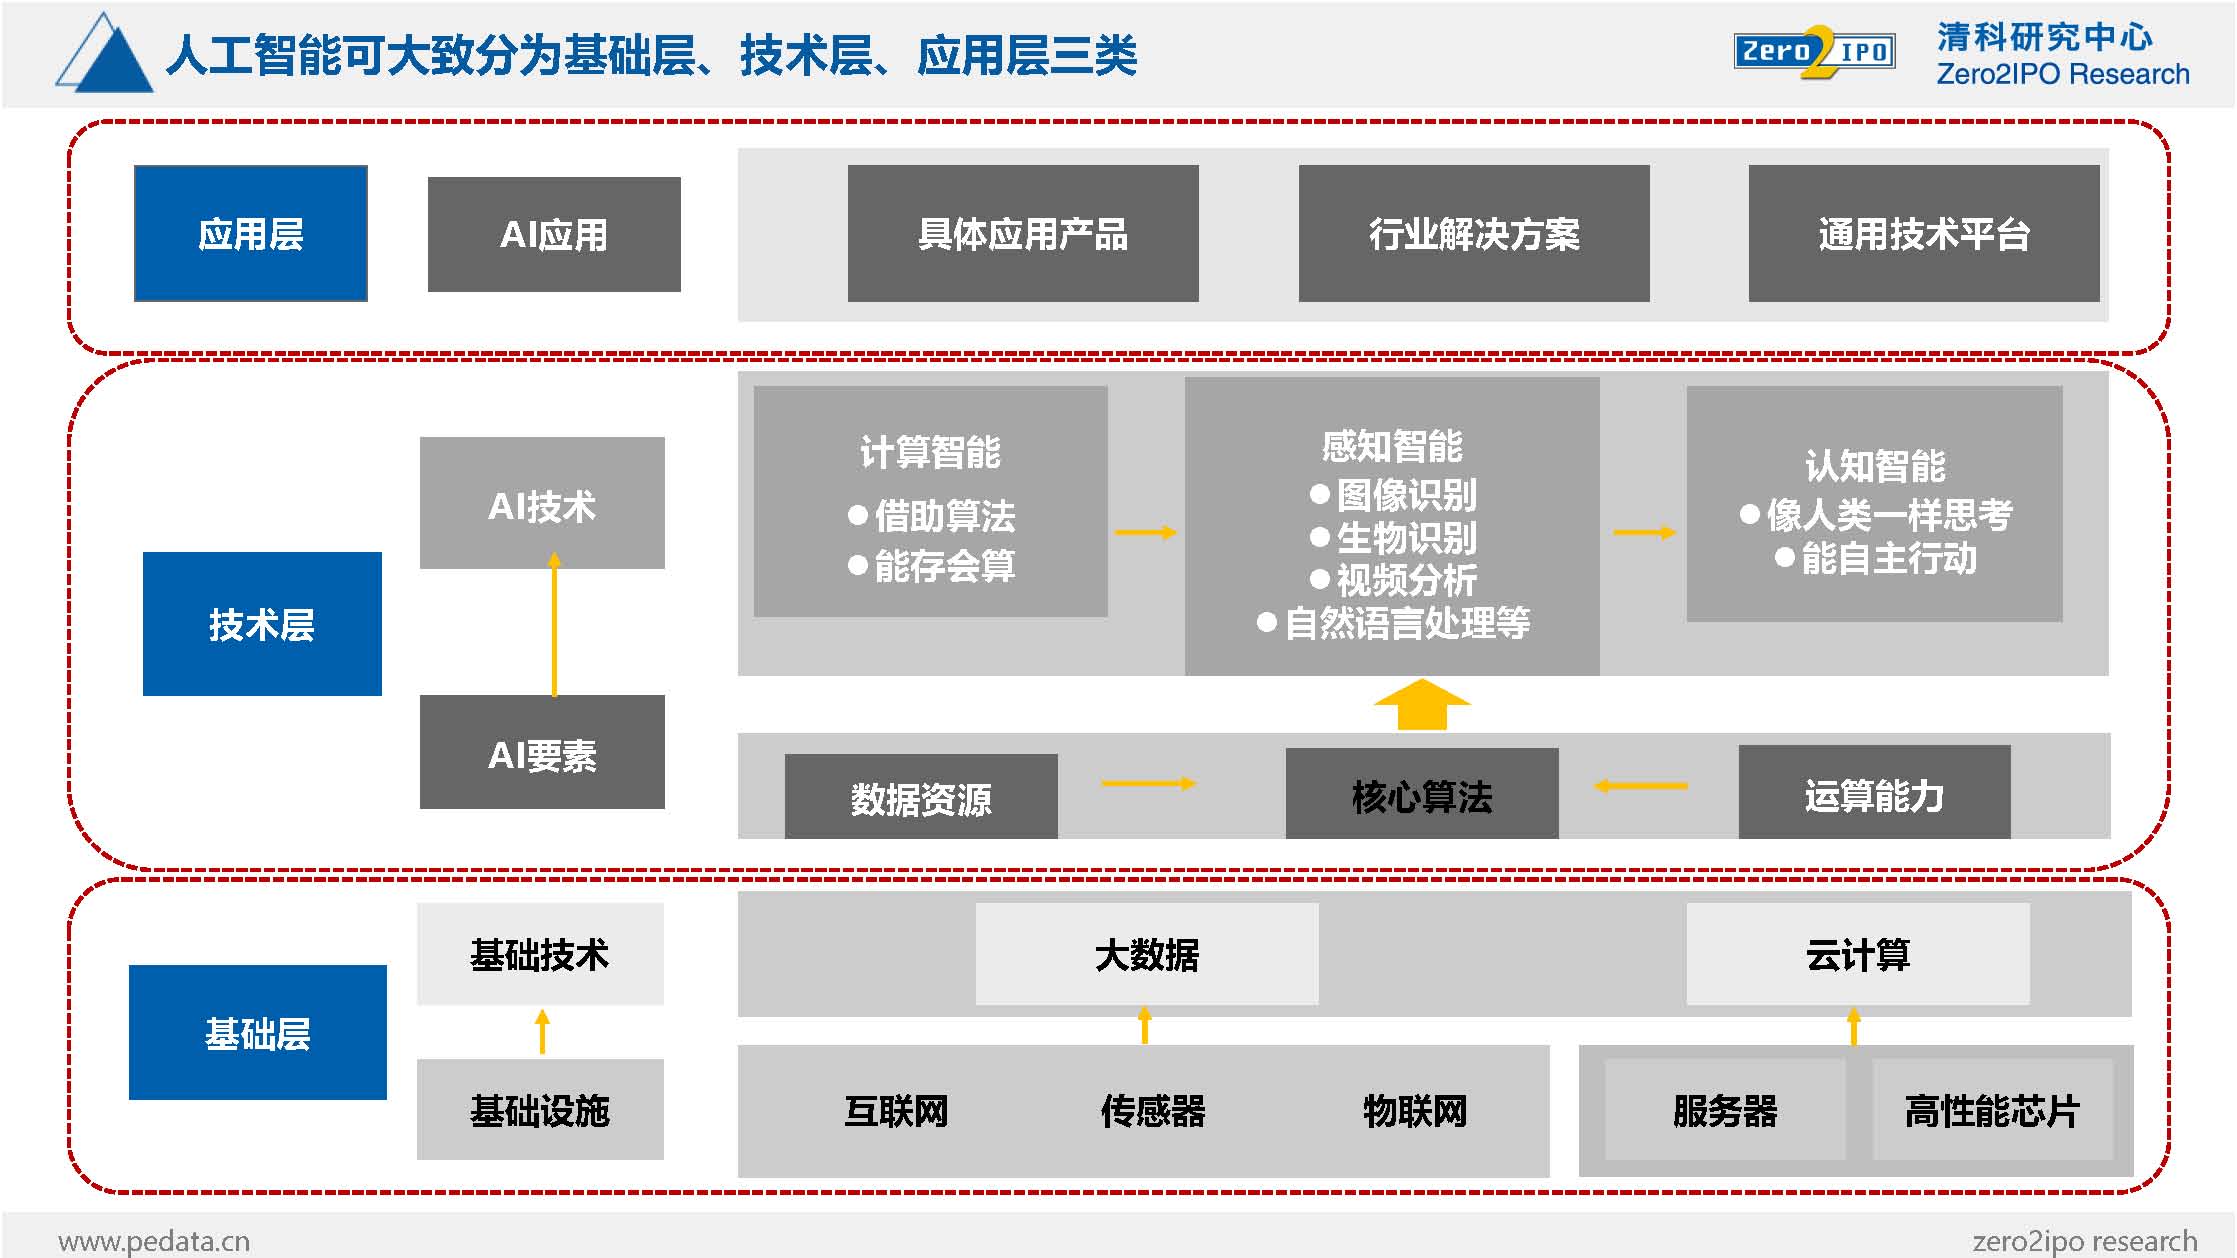
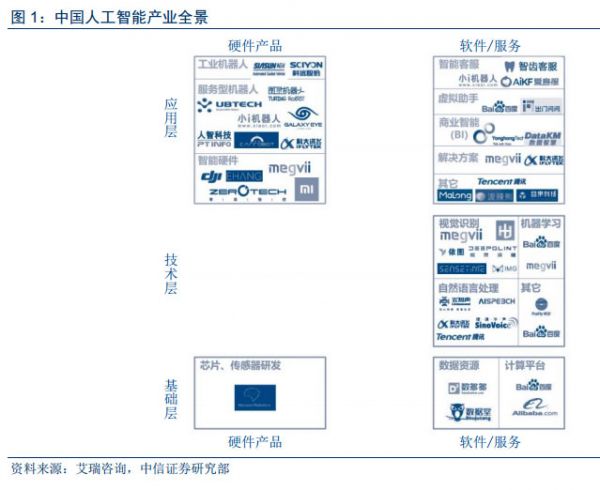
引言\n\n人工智能(AI)正以前所未有的速度重塑人类社会,从AlphaGo的惊世一棋到ChatGPT的流畅对话,其背后是计算能力的指数级增长、海量数据的持续积累与算法模型的不断突破。要真正理解AI的运作逻辑与发展边界,必须回归计算机基础——计算资源、数据资源与核心技术这三根支柱。它们共同构成了人工智能从实验室走向产业化的底层底座,决定了AI能做什么、不能做什么,以及下一步该往何处去。\n\n## 一、AI的计算基础:算力即权力\n\n计算机体系结构为AI提供了原始的“体力”。现代AI,尤其是深度学习的训练,本质上是海量矩阵运算和微分计算。传统CPU虽然通用,但在并行处理上先天不足。GPU凭借数以千计的流处理器,成为当前AI训练的主力硬件。一次大语言模型的预训练可能需要数千块GPU连续运转数周,电费以百万美元计。专门化的AI芯片如TPU、NPU,通过脉动阵列等架构设计,进一步将能效比推向新高度。在计算机基础的视角下,存储层次(寄存器、缓存、内存、外存)深刻影响AI的吞吐效率。计算图优化、混合精度训练和图编译器(如TVM)正是在这些限制下寻找“算力最优解”的工程实践。可以说,没有计算机硬件与体系结构的持续演进,任何精巧的AI算法都是空谈。\n\n## 二、AI的数据与算法资源:燃料与引擎\n\n数据是AI的燃料。监督学习依赖大批量标注数据,自监督学习则从无标注文本、图像中挖掘规律,而强化学习则在交互中自发搜集经验数据。互联网、物联网和传感器网络每天都在生成每字节价值不等的数据流,但真正可用的AI就绪型数据仍需经过采集、清洗、特征工程与质量评估。“垃圾进,垃圾出”始终有效。开源数据集(ImageNet、COCO)与通用语料(Common Crawl)构成了技术准入的门槛,同时也催生出社区共享的模型即服务生态。\n\n在算法层面,传统的机器学习模型(SVM、决策树、随机森林)仍是AI工具箱中不可或缺的部分,易于理解和部署。深度学习凭借卷积网络、循环网络和Transformer三大结构主导感知任务。训练微调术、蒸馏压缩、网络架构搜索拓宽AI资源有限时的适用边界。预训练加任务微调(Pretrain+Fine-Tune范式与提示学习
如若转载,请注明出处:http://www.taokebarr.com/product/51.html
更新时间:2026-10-11 00:00:42